溪木源:成分表没退场,实测过程只进来 1 条
2026-11-03 单日,溪木源在彩妆护肤类目有 825 条素材在投。本篇只数一件事:这 825 条里,「把成分念一遍」和「把过程拍一遍」各占多少。答案是一边倒——过程侧全池 1 条。
核心发现
四句话讲清这次计数的结果:过程侧少到什么程度、成分侧缺的是什么、骨架长什么样、变化发生在哪一层。
825 条里唯一带数字化功效承诺的是 M57642,标题写「4 周泛红 -42.1%」。300 条抽样还是这 1 条,120 条逐条核读里连一条同机位时间轴都没有。
6 类信任物证里 3 类仍在用(代言人、专利、持证成分),3 类为零(质检报告、临床数据、第三方榜单)。「双专利」被反复念,全样本 0 个专利号。
约 45% 的素材首句就在报价格,88% 的第一句不提产品名。成分解释要等到第三层才出现——所谓「成分表」在这批素材里是术语点缀,不是结构主体。
120 条里剧情演绎 0 条,而这个结构位只占赛道素材的 1.4%,却拿到过 2.0 亿单条曝光。空位在结构层,不在措辞层。
825 条的三件事:母本稳、寿命长、新素材少
先把体量与节奏摊开,后面的「形态」判断才有分母。
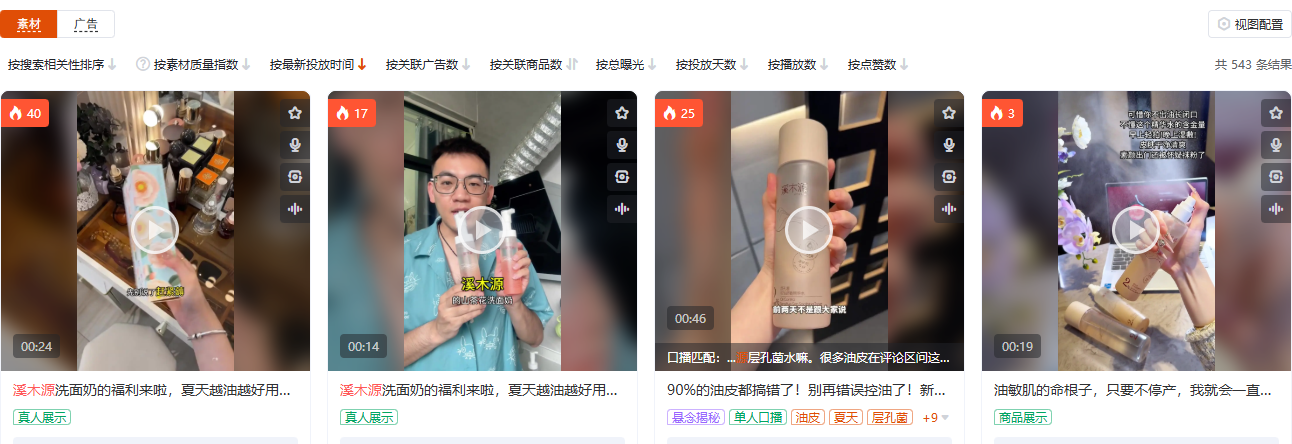
825 条这个量放赛道里不算大。同口径下薇诺娜 3,020 条、可复美 1,227 条、玉泽 801 条,溪木源与玉泽基本齐平,至本只有 47 条。它靠的不是堆量,是同一批母本反复投。
82% 是旧素材在续投。样本里投放天数 133 天、117 天、102 天各有一条,最长的一条从 2025-05-04 一直投到 2026-11-04,跨了一年半。
| 品牌 | 在投素材(条) | 与溪木源比值 | 主力内容形态 | 可核验物证 |
|---|---|---|---|---|
| 溪木源 | 825 | 1× | 单人口播+价格清点 | 0 个专利号 |
| 薇诺娜 | 3,020 | 3.7× | 自播号矩阵+代言人 | 医院临床(品牌层) |
| 可复美 | 1,227 | 1.5× | 剧情短剧二创 | 20 年胶原叙事 |
| 玉泽 | 801 | 0.97× | 单一口播母本 | 上海家化+23 年 |
| 至本 | 47 | 0.06× | 品牌宣言,无叫卖 | 销量与直发售后 |
这张表能读出的是「量级」和「形态」两件事,不能读出效率。溪木源与玉泽条数几乎相同,形态却分两端:玉泽是 1–2 个口播脚本反复重剪,溪木源是多个自播号并行、同一母本挂到上百条广告组。前者省人,后者省创意,两种都成立,但都不产出「过程」。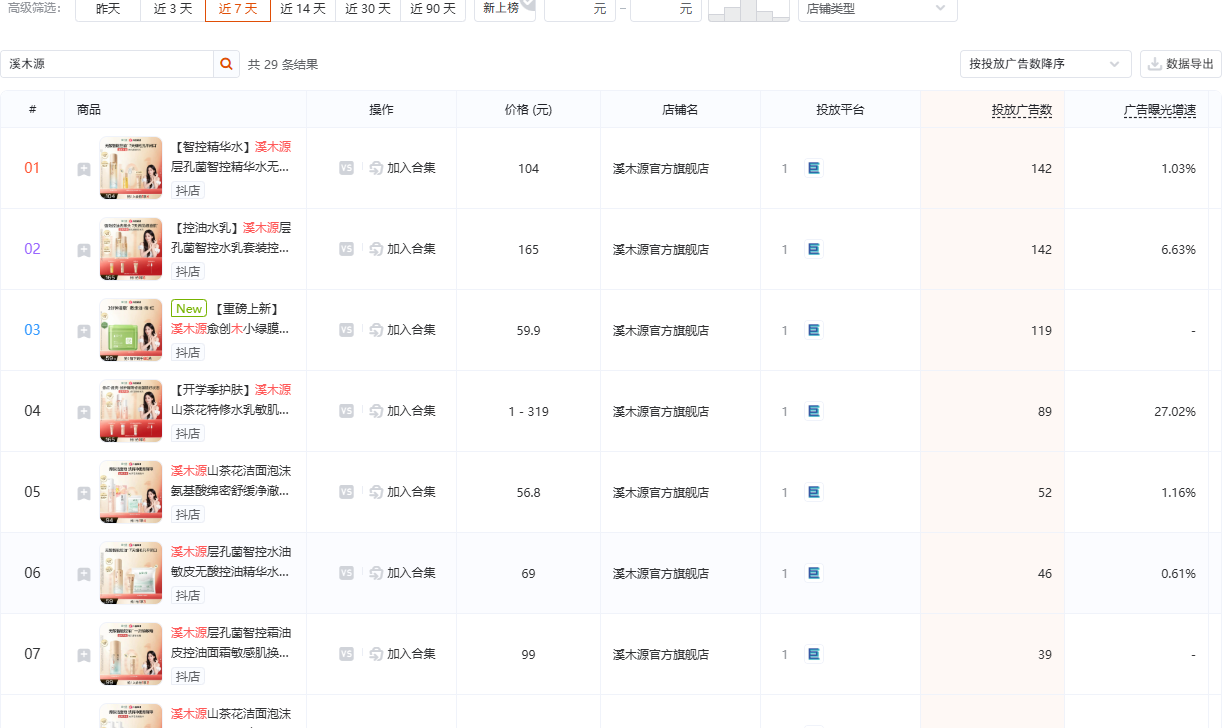
骨架五层:价格在最前,成分排在第三层
「成分表」这个词有误导性。在这批素材里,成分不是开场,是解释。
五层的顺序是固定的,换达人、换 SKU、换赠品都不动这个顺序。约 45% 的素材首句就在报价格;88% 的第一句不提产品名,品牌名通常落到第二三句。
先让人停下来。约 45% 的素材把这一层放在首句。
锁住是谁在看。「油皮姐妹」「大油皮」直接点名。
回答为什么有用。层孔菌 PRO、舒敏安、无酸控油在这一层出现。
给一个能看见的动作。喷 15 到 20 厘米、拍两下吸收。
把犹豫压成动作。库存、赠品、进直播间。
第三层与第四层是关键。第三层是「说」,第四层是「做」,两者加起来才构成消费者看到的「证据」。而这两层在 30 秒内要连着走完,留给验证的时间几乎为零。
| 层级 | 作用 | 台词原话 | 代表素材 |
|---|---|---|---|
| L1 价格机制 | 先让人停下来 | 「昨天199你不嫌贵,现在点进直播间全场5折」 | Md63f2 |
| L2 人群喊话 | 锁住是谁在看 | 「油皮姐妹们注意了」 | M89753 |
| L3 技术解释 | 回答为什么有用 | 「双专利配置的控油水……专利超分子层孔菌PRO平衡皮脂分泌」 | M163d3 |
| L4 体验演示 | 给一个能看见的动作 | 「换上秒变喷雾」「15到20厘米一喷」 | M4a5f9 |
| L5 稀缺收口 | 把犹豫压成动作 | 「溪木源给大家道歉了,昨天买过的对不起」 | Mf0766 |
顺序决定了一切。价格在最前,意味着用户对「值不值」的判断先于「有没有效」;成分排在第三层,意味着它只需要听起来有机制,不需要被验证。第四层的「演示」之所以不能算「实测」,就是因为它只有一次动作,没有第二个时间点做对照。
成分侧:名词齐全,编号为零
把六类信任物证摊开,能看出「成分」在这批素材里承担的是解释功能,不是证明功能。
六类物证里,三类有、三类空。有的三类是代言人、专利名词、持证成分;空的三类是质检报告编号、临床检测数据、第三方榜单。这个组合很像「术语信任」:说法齐全,凭据为零。
| 物证类型 | 是否出现 | 具体情况 | 代表素材 |
|---|---|---|---|
| 代言人 | 有 | 蔡徐坤「全球品牌代言人」、沈月「品牌灵动大使」 | M7cc5d Ma3e09 |
| 专利 | 只有「说了有」 | 反复出现「双专利」「专利层孔菌 PRO」「专利舒敏安」,全样本未出现任何专利号 | M94428 |
| 特证成分 | 模糊 | 「持证成分舒敏安」,只给「持证」二字,无证号 | Mc82c8 |
| 质检报告 | 未见 | 样本中无报告编号、无实验室镜头 | 120 条样本整体 |
| 临床检测 | 极弱 | 仅「敏感肌实测」类口头表述,无数据、无读数 | M24be1 |
| 第三方榜单 | 未见 | 同赛道谷雨敢说「抖音排名 top1」,溪木源样本内无同类表述 | M11e7d |
「未见」要说得准确一点:它指的是样本里的台词和画面没出现,不是品牌没有报告。平台没有资质库字段,能读的只有素材说了什么。这条边界很重要,因为它决定了这份报告能主张什么、不能主张什么。
口径:全样本台词核读,编号指可被截图检索的专利号或特证号。
对比之下,竞品的信任状都有「出处」:薇诺娜有医院临床背书,可复美讲 20 年重组胶原,玉泽挂上海家化与 23 年屏障修护。溪木源把信任押在名词上,名词不需要出处也能听懂,这是它的效率,也是它的上限。
名词能解释机制,解释不了它有没有效。
实测侧:四个分母指向同一个答案
「实测」不是形容词,是可以被数出来的。这一节把四个分母并排放,避免用一个大数字讲一个小结论。
统计「实测」先要定标准。本篇用三条同时成立来判定:有可核验的编号或读数、有同机位的第二个时间点、有能被公开复述的分母。三条缺一条,只能算「演示」。
| 分母 | 样本量 | 实测过程型 | 占比 | 判定依据 |
|---|---|---|---|---|
| 11-03 全池 | 825 条 | 1–2 条 | 0.12%–0.24% | 唯一带数字化功效承诺的是 M57642,标题写「4 周泛红 -42.1%」 |
| 曝光排序抽样 | 300 条 | 1 条 | 0.33% | 与全池同一条,未出现第二例 |
| 逐条核读样本 | 120 条 | 0 条 | 0 | 0 条同机位时间轴,0 条检测报告或实验室镜头 |
| 关键词定向检索 | 825 条 | 0 条 | 0 | 用 ASR 检索「检测报告」「实验室」,命中 0 条 |
四行指向同一件事:过程型内容存在,但只存在一条。它还不是范式,是一次孤例。把它当作「趋势已经形成」来引用,会让后面所有推论失真;把它当作「有人试过并留下了样本」,才是它现在的真实位置。
这里必须把边界说清。成分侧没有同口径的条数——这批数据能给出的是类型数(6 类里 3 类在用)和提及率(≤3 条,≤2.5%),给不出「成分罗列型占百分之几」。所以本篇不写「从 A 降到 B」,只写「过程侧有确数,成分侧有类型」。
这条边界不是退让,是让结论站得住。一个只有单侧分母的趋势断言,读者无法复核;两个不同分母硬拼在一起,看起来更有说服力,实际上更脆。
八类钩子里,没有一格留给「实测」
前 3 秒决定这条素材被不被划走。八类钩子里,七类在讲「你会亏」,一类在讲「我有人」。
112 条样本的首句可以归成八类。价格落差与错过叠加两类合计约 45%,加上圈人群喊话 15%,前三类就占掉六成。悬念、纠错、社交情绪分摊剩下的位置。没有一类是「我给你看一个数」。
钩子之外还有一层可以交叉验证:画面标签。有明确结构化标签的少数素材里,出现的是「柔光/专业影棚/产品包装特写」和「自然光/客厅/上手试质地」两种路线,一个拉调性,一个建信任,都不含实验场景。
| 钩子类型 | 占比 | 代表首句 | 素材 |
|---|---|---|---|
| 价格落差/后悔式 | 25% | 「昨天199你不嫌贵,现在点进直播间全场5折」 | Md63f2 |
| 错过叠加式 | 20% | 「错过了99一瓶,又错过199两瓶」 | Mf474f |
| 圈人群喊话式 | 15% | 「油皮姐妹们注意了」 | M89753 |
| 纠错/反常识式 | 10% | 「90%的油皮都搞错了」 | M621cd |
| 社交情绪/关系式 | 10% | 「Crush一句你脸好油好多痘啊,我果断下单」 | M7f2cf |
| 悬念/打赌式 | 8% | 「我打赌你不知道水乳的隐藏用法」 | M44783 |
| 明星官宣式 | 7% | 「不会还有人不知道我们代言人要来直播间了吧」 | M7cc5d |
| 道歉式反稀缺 | 5% | 「溪木源给大家道歉了,昨天买过的对不起」 | Mf0766 |
这张表最有用的地方不是占比,是缺项。八类钩子里,任何一类都指向「你不动手就亏」或「我请了谁」,没有一类指向「我给你看证据」。要加第九类,成本不在拍摄,在于它必须带一个可以被截图检索的物件——编号、报告、读数,三者之一。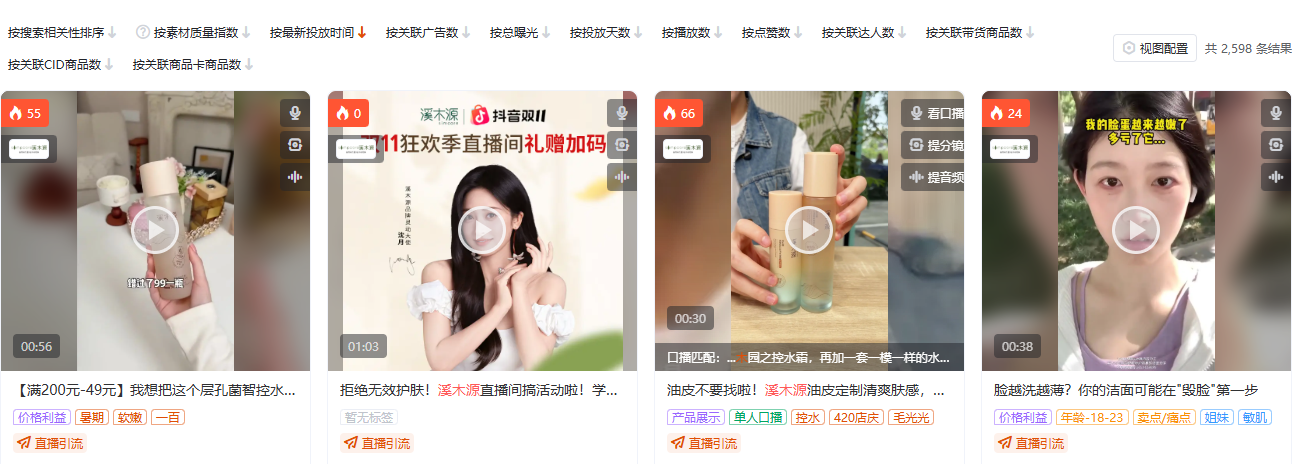
38% 的素材落在 16 到 30 秒,装不下一个「过程」
时长不是唯一障碍,但它是一道硬门槛:过程需要两个时间点,两个时间点需要秒数。
把 112 条按时长分档,16–30 秒占 38%,31–60 秒占 33%,≤15 秒占 18%,超过 60 秒占 11%。主力档是 16–30 秒——刚好够「钩子+机制+收口」三件事,不够放第 1 天和第 7 天。
31–60 秒这一档理论上够放两个时间点,占 33%,接近三分之一。样本里没人这么用:这一档全部用在「逐件报赠品」和「完整机制讲解」上,秒数花在清点上,没花在对照上。
所以说白了,时长不是关键约束。同样 30 秒,M621cd 用来讲「这瓶里面没有酸,控油效果跟酸一样」,也可以用来放第 1 天与第 7 天的同一块脸颊。改的是分镜顺序,不是预算。
反过来看,这也解释了为什么「演示」替代了「实测」:喷一下、拍两下只占 2 秒,效果直观,成本几乎为零;时间轴要拍两次、要对机位、要留原片,还得接受「第 7 天变化不明显」的风险。选择演示是理性的。
对标:整圈竞品也没人把「过程」做成主线
如果只有溪木源没做,那是它的问题;如果四家都没做,那是结构位的问题。
拿可复美做正面对照最合适:同价位水乳、同敏感肌人群、同千川渠道,唯一在「水乳」单品上正面交战的对手。它的内容形态比溪木源高一个维度,但高的那一维是剧情,不是实测。
可复美的百万级曝光来自剧情:《如懿传》二创 540 万、偶遇剧情 677 万、情绪剧情 484 万。剧情能拿到自然流量,但剧情证明的是「有人看」,不是「有效」。它和实测解决的是两个不同问题。
| 品牌 | 被当成证据的东西 | 属于哪一类 | 代表素材 |
|---|---|---|---|
| 溪木源 | 双专利名词、持证成分、喷头演示 | 术语+单次演示 | M163d3 |
| 可复美 | 20 年专研、医学生人设、剧情冲突 | 资历+剧情 | Mb28e0 |
| 玉泽 | 「冰镇厚敷法」、反向劝退话术 | 使用方法 | M26255 |
| 薇诺娜 | 件数堆叠(二单 40 件)、医院背书 | 数量+机构 | M40ebb |
| 至本 | 累计销量、官方直发、七天无理由 | 销量+售后 | M7bf81 |
玉泽的「冰镇厚敷法」最接近过程,但它给的是用法,不是效果对照:观众学到的是「怎么用」,不是「用了会怎样」。两者差一个第 7 天。这也是本篇把「使用方法」和「实测过程」分开数的原因,否则统计会虚高。
至本提供了另一种参照:47 条素材、94% 由同一品牌号发出、文案几乎无叫卖。它不做叫卖也不做实测,走的是价值观路线。这说明「不叫卖」和「给证据」是两条不同的路,不能互相替代。
人群:油敏肌被一个词打穿,过程最该给的是换季干敏
过程型内容的说服对象,恰恰是这批素材完全没碰的那群人。
120 条里约 33 条直接圈「油敏肌/大油皮/油痘肌」,人群词全部围绕出油、闭口、黑头。产品名即人群名,「油皮定制」这种写法把语义场收得很窄。窄有窄的好处:算法和用户都只认一个词。
向量宿舍/浴室场景,自然光,素颜出油,价格敏感
钩子单瓶折算、错过叠加、圈人群喊话
向量办公室/居家,怼脸近景,T 区泛油
钩子状态对比口播、即时体感
向量仅 1 条明确打干敏,无场景展开
钩子顺带提及,不是主诉求
向量母婴、儿童、银发不在 audienceTag 内
钩子无对应素材,属结构性空白
这张人群表解释了一个矛盾:最需要「过程」的人不在这批素材的射程里。油敏肌要的是「别更油」,一次喷雾演示就够;换季干敏、医美后、孕期要的是「会不会刺激我」,只有第 1 天与第 7 天的对照能回答。
人群窄不是错误,是选择。代价是当品类从「控油」扩到「修护」时,这套语义场接不住新人群——而修护恰恰是最依赖过程证据的诉求。
从一家品牌到整条赛道:五个阵营,实测都不在核心
把溪木源放回赛道坐标,才看得出「过程缺位」是个体问题还是结构问题。
近 90 天,彩妆护肤直播引流池 5,167,936 条、商品广告池 6,861,696 条,溪木源 13,979 条,占 0.12% 到 0.27%。它是「峰值型」打法:素材少、单条高。薇诺娜同期 104,580 条,日均 1,162 条,是它的 7.5 倍,走的是覆盖型。
单点人群深打、机制分期叙事、达人矩阵复刻、代言人作旗帜。峰值高、供给中等。
医研与械字号物证、自播号矩阵高频轮播。素材量最大,单条峰值约为溪木源的三分之一。
明星、剧情大片、大曝光洗人群。剧情演绎 TOP 曝光 2.0 亿、1.6 亿、1.3 亿几乎被这一档垄断。
无品牌露出,纯自拍口播,SKU 海量试错。价格是唯一变量。
无内容叙事,只挂价格与商品卡。抽样中大量 0 台词、0 曝光素材。
五个阵营的信任锚分别是:医院、明星、代言人加成分、价格、商品卡。没有一类的核心是「过程」。这不是溪木源一家的选择,是整个类目在「证据」这件事上的共同省略。
| 阵营 | 素材供给特征 | 信任锚 | 过程含量 |
|---|---|---|---|
| A 医研型 | 日均千条级、多自播号矩阵 | 医院、临床、械字号 | 有机构背书,无时间轴 |
| B 品牌型 | 单条大制作、低供给高曝光 | 明星、剧情、大片 | 无 |
| C 新锐型 | 万级供给、单条峰值百万 | 代言人、成分故事、销量 | 1 条(溪木源) |
| D 白牌型 | SKU 极多、单条粗糙 | 价格 | 无 |
| E 货架型 | 686.2 万条、零叙事 | 商品卡 | 无 |
把这张表和前面四个分母放在一起看,结论会更清楚:整个类目的「证据升级」还停在机构层(医院、企业、代言人),没有下沉到个体层(同一个人的第 1 天和第 7 天)。机构层靠预算买,个体层靠设计做——后者才是中小品牌能抢的位。
空位:1.4% 的素材池,藏着 2.0 亿的曝光上限
供给最少的结构位,往往也是上限最高的那个。这条规律在彩妆护肤里同样成立。
剧情演绎素材只有 73,753 条,约为直播引流池的 1.4%。但赛道单条曝光的顶部几乎都在这里:2.0 亿、1.6 亿、1.4 亿、1.3 亿。低供给、高上限,这是结构位的典型特征。
| 结构位 | 素材量 | 占比 | 曝光上限 | 溪木源是否占位 |
|---|---|---|---|---|
| 剧情演绎 | 73,753 条 | 1.4% | 2.0 亿 | 0 条 |
| 直播引流 | 5,167,936 条 | 主体 | 293 万 | 98% 押在这里 |
| 商品广告 | 6,861,696 条 | 主体 | — | 约 8% |
| 同机位时间轴实测 | 1 条 | 0.12% | 未知 | 1 条(M57642) |
最后一行要单独说:时间轴实测没有可靠的曝光上限可引用,因为样本只有 1 条,而且是时长极短的商品广告形态,曝光 3,363。这个数字既不能证明它无效,也不能证明它有效——它只能证明有人试过一次。
「成分表变成实测」这件事在 825 条里只完成了 1 条,说趋势太早,说空位更准。
全池 1–2 条(0.12%–0.24%)/300 条抽样 1 条(0.33%)/120 条核读 0 条时间轴/ASR 检索 0 条;剧情池 1.4% 却拿到 2.0 亿上限。
把「第 1 天/第 7 天」做成 8 秒固定分镜,插进现有骨架的第 9 到 15 秒,不改清点节奏。
说白了,谁先把「同一块脸、同一盏灯、第 1 天和第 7 天」拍成固定件,谁就先拿到这个空位。它不需要新预算,只需要一个新分镜位。
能学的三条:母本可复用、人群可收窄、结构位可抢
溪木源的做法里有三条是可迁移的,且都不依赖它的品牌资产。
第一条是母本库。同一句「错过了99一瓶,又错过199两瓶」在样本里至少复现 4 条,同一句「这是一个超级好用的油皮水」至少 7 条。它验证过哪句话能起量,之后只换达人和拍摄。
单条素材的生命周期被拉到 133 天,靠的不是创意持续输出,而是同一句台词在不同账号、不同广告组里反复投。组织成本低,验证成本更低。
「油敏肌的控油」比「控油」多了一层身份。身份一旦被接受,后面所有机制话术都站在这个前提上,解释成本骤降。
低供给意味着竞争少,高上限意味着天花板高。溪木源 120 条里剧情 0 条,等于把这一格整块让出去;实测这一格,全池只有 1 条。
三条的共同点是:都不需要新预算。母本复用是流程问题,人群收窄是定位问题,结构位是分镜问题。这三件事恰好也是一家中腰部品牌最容易改的三件事。
学不了的三条:代言人、渠道垄断、价格空间
可迁移的说完,把不可迁移的也标出来,抄作业才不会抄错页。
代言人这条最直接。蔡徐坤 4 条、沈月 3 条,合计约占样本 6%,曝光最高的明星素材 77.9 万。这类资产花的是预算和时间,不是创意能追的。
| 学不了的 | 它的量级 | 为什么学不了 |
|---|---|---|
| 双代言人资产 | 明星素材约占 6%,单条 77.9 万 | 签约周期与费用是门槛,短期无法复制 |
| 价格空间 | 175 元 7 件,单瓶不到 60 | 同品牌并存 7 个价格锚,区间 60 到 399 元,靠的是供应链让利 |
| 自播号矩阵 | 4 个自播号并行,单条关联广告 100+ | 需要稳定的直播团队与投放组织,不是素材层能解决的 |
价格这条要格外小心。同品牌同时出现 60/80/175/184/199/329/399 这些锚点,还并行「全场 5 折」与「一折」,用户在品牌内就能比价。这套打法能起量,但会透支复购,而且它本质上不是内容能力,是让利能力。
自播号矩阵同理。4 个号并行、单条母本挂 100+ 广告组,这是组织效率,不是创意效率。抄它的脚本容易,抄它的排班和投放密度很难。
证据边界:这批数据能主张什么,不能主张什么
把不可证的先划掉,剩下的才是可以拿去用的结论。
能被这批数据支持的只有形态判断,不能支持效果判断。平台不提供消耗、GMV、点击率与完播,所以「哪种形态更划算」这个问题,本篇回答不了,也不该假装能回答。
| 结论 | 证据状态 | 说明 |
|---|---|---|
| 实测型内容在全池只有 1 条 | 可证 | 四个分母交叉,条数可复核 |
| 成分名词仍在用、编号为零 | 可证 | 6 类物证逐类核读,编号检索为空 |
| 溪木源「从成分表变成实测」 | 不成立 | 过程侧只有 1 条,替代关系不存在 |
| 成分罗列型占多少百分比 | 不可得 | 样本只支持类型计数与 ≤2.5% 的物证提及率 |
| 实测型比叫卖型更有效 | 不可得 | 缺消耗、转化与完播,无法做效率比较 |
写这份报告的起因是一个听起来顺理成章的判断:敏感肌内容正在从罗列成分表,转向展示实测过程。数完之后,这个判断只在半句话上成立——「从罗列成分表」是真的,「转向实测过程」还差 824 条。
宁可把结论说小一点。内容形态确实在动,动的是术语的讲法和人群的切法;跨到「过程」那一步,整条赛道都还没迈出去。这对读者反而是好消息:空位还在。
数据来源与方法
关于有米有数
有米有数是有米云旗下的 AI 驱动内容电商营销大数据策略平台,聚焦抖音电商生态,覆盖洞察、决策、策略、素材、投放与归因全链路。平台依托 5 亿+ 商品数据与 3 亿+ 广告素材库,结合多模态大模型能力,提炼抖音需求的向量化特征与内容特征,为品牌提供卖点视觉化策略。
常见问题
溪木源真的从讲成分改成拍实测过程了吗?
没有。2026-11-03 单日 825 条在投素材里,同时满足「有编号、有同机位时间点、有公开分母」的实测型内容只有 1 条(M57642「4 周泛红 -42.1%」),占 0.12%;300 条抽样 1 条,120 条核读 0 条同机位时间轴。成分那侧没有退场:层孔菌 PRO、舒敏安、双专利仍在念,只是没有一个带编号。能说的是「实测刚进门一条腿」,不能说「已经换成实测」。
为什么 825 条里只有 1 条能算「实测」?
因为多数素材做的是「演示」而不是「实测」。演示是单个动作,喷一下、拍两下、湿敷一次,看完只能相信主播的手;实测要有时间轴和参照物,第 1 天和第 7 天要同机位、同一块脸,读数要能被截屏。平台侧能读到的证据是:120 条样本里 0 条同机位时间轴,0 条检测报告或实验室镜头,用 ASR 定向检索「检测报告」「实验室」在 825 条池里命中 0 条。缺的不是拍摄能力,是可核验的设计。
成分名词没有编号,为什么在这条赛道里仍能跑量?
因为敏感肌的决策顺序是「先别刺激我」,再「有没有效」。前半段靠人群词就够用:120 条里约 33 条直接圈「油敏肌/大油皮/油痘肌」,把「控油」重写成「油敏肌的控油」,消费者先认了身份。后半段靠术语解释:双专利、无酸控油、智能分区,都是听起来有机制的词。样本里提及权威物证的只有 ≤3 条(≤2.5%),说明这个品类的信任目前主要靠身份认同和术语,不靠编号。这是它能跑量的原因,也是它的天花板。
想看清一个品牌的内容形态到底变没变,用什么工具能查清?
分四层查:素材层看同一天的条数与首句,判断它是靠母本复用还是靠日更;结构层看钩子类型与时长分布,判断「过程」有没有位置;证据层把台词里的编号、报告、读数逐条抄出来,没有编号就不算证据;人群层比对 audienceTag 与话术是否对应。有米有数素材分析平台把这四层放在同一个素材库里,可按品牌、类目与时间窗回看台词与画面标签,本篇「过程侧 1 条、成分侧 0 个编号」的结论就是按这个顺序数出来的。